ChatGPT対Claude:アイデアを実行する前に使う、6ステップのAI意思決定システム
ChatGPTとClaudeに、互いのアイデアを採点させました。9.6点は6.5点になりました。そこから生まれた仕組みと、今週から自社で使う方法を紹介します。
Useryze · 公開
結論から: 1つのAIモデルに答えを聞いて、そのまま実行するのはやめましょう。同じ依頼を2つのモデルに渡し、先に書いておいた基準で互いのアイデアを採点させ、品質の合格ラインを決め、3ラウンドで止め、最後の判断は自分で下します。私たちはこれを実際のプロジェクトで試しました。ChatGPTは自分のアイデアの1つに10点満点で9.6点を付けました。Claudeが同じアイデアを見て付けたのは6.5点です。この差こそが、今回の学びのすべてです。
9.6点が6.5点になった話
GTA 6の発売週に向けて、ショート動画のアイデアが必要でした。1つのモデルにリストを頼むのではなく、ChatGPTとClaudeを同じ共有ドキュメントに入れて競わせました。
第1ラウンドは穏やかでした。各モデルが3つずつコンセプトを書き、6つすべてを採点しました。どのコンセプトでも、2つの点数の差は1点未満。最高評価のアイデアは、Claudeが8.5点、ChatGPTが8.8点でした。
これは証拠のように見えます。しかし違います。同じインターネットの多くを学習した2つのモデルは、同じ盲点を持っていることがあります。意見が一致することと、正しいことは別です。
そこで基準を上げ、本気で9.5点を狙えるアイデアを両方に求めました。ChatGPTは新しいコンセプトを3つ出し、目標点を9.6、9.6、9.7としました。Claudeも3つ書き、9.2から9.5と評価しました。9点台を求めたとたん、両モデルとも9点台を返してきたのです。
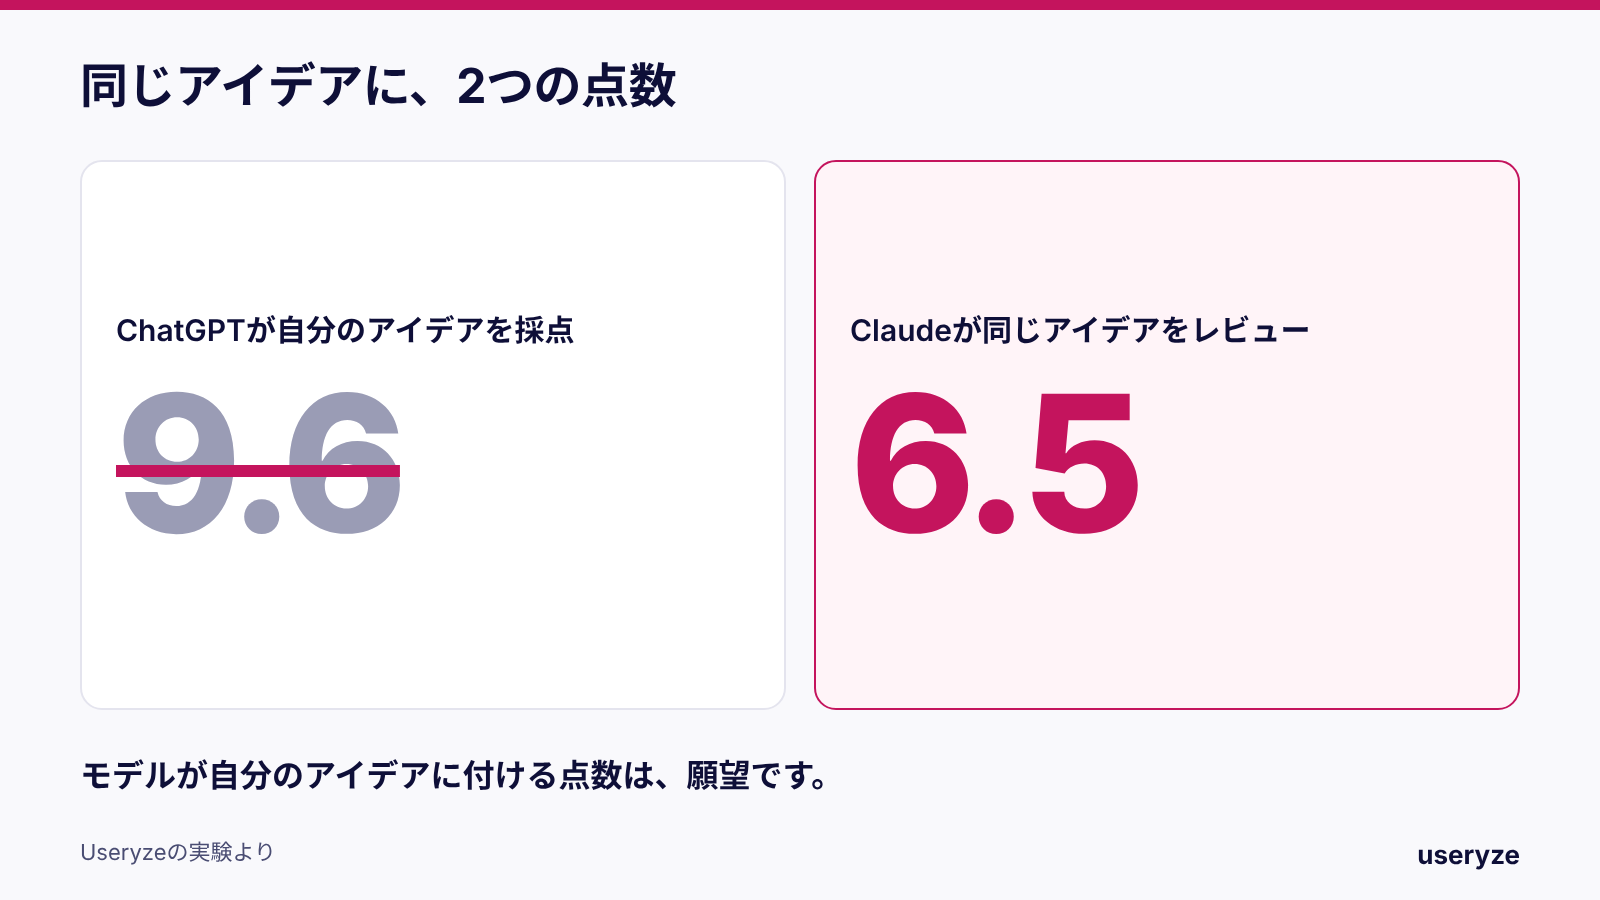
次に、互いの答案を交換させました。9.6点は6.5点になりました。中心となるジョークが成立していなかったからです。Claude自身のお気に入りも、冒頭が弱いという理由で9.5から9.2に下がりました。その後ChatGPTは、最初の点数は願望に近く、高すぎたと書いています。
モデルが自分のアイデアに付ける点数は、願望です。
なぜプロンプト1回はコイン投げなのか
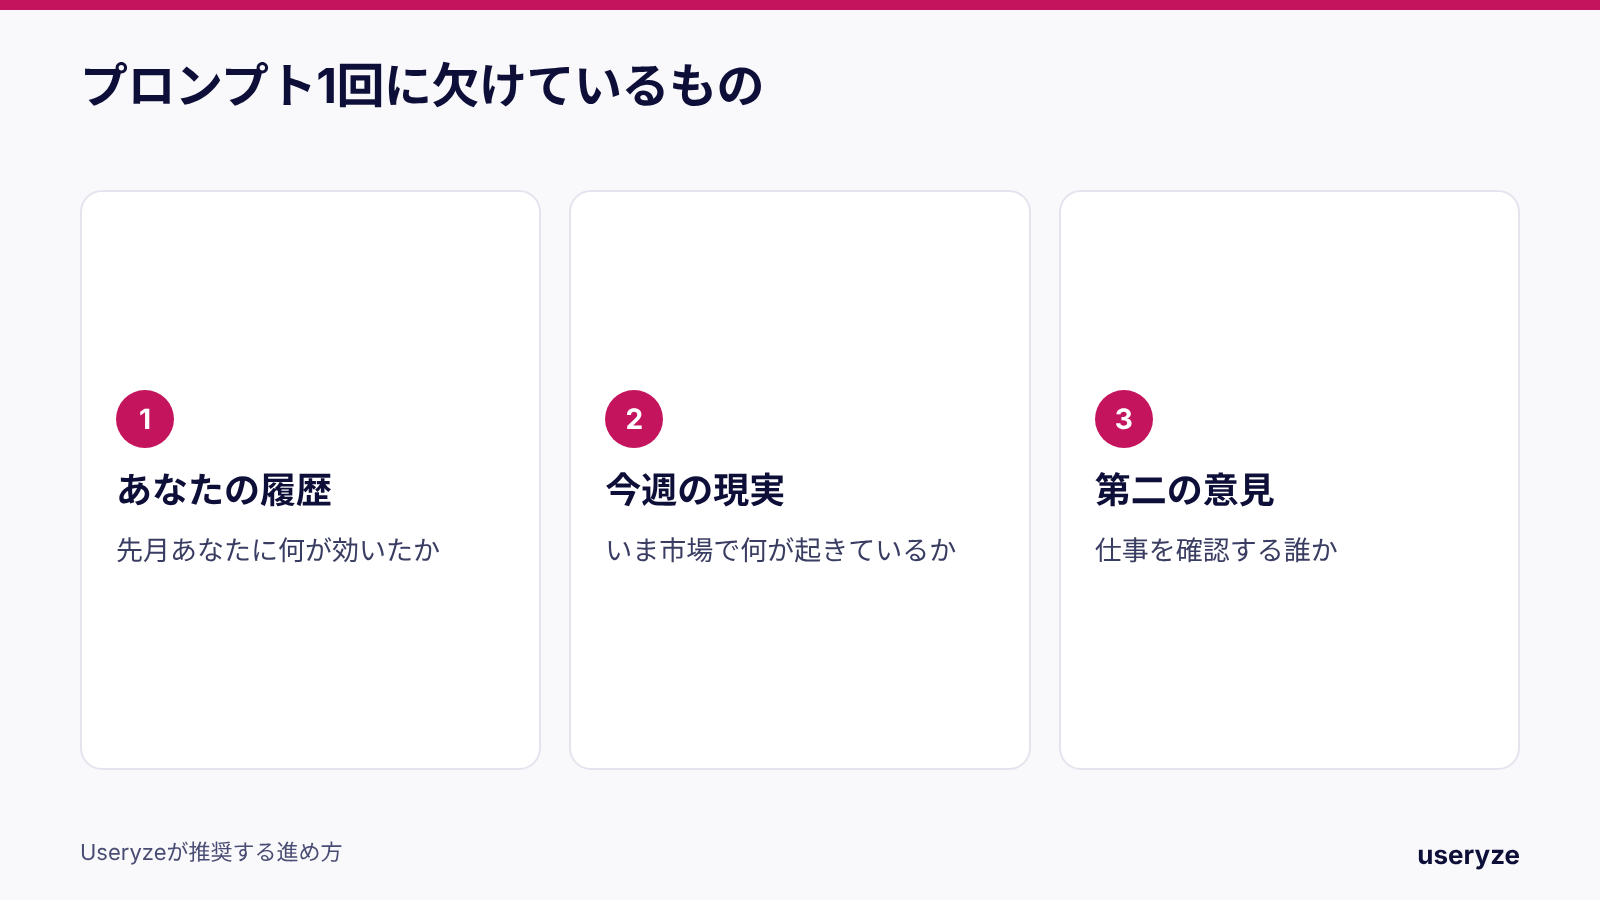
多くの人のAIの使い方はこうです。質問を入力し、自信ありげな答えを受け取り、実行する。ここには3つのものが欠けています。
- あなたの履歴。 モデルは、先月あなたに何が効いたかを知りません。
- 今週の現実。 いま市場で何が起きているかを知りません。
- 第二の意見。 誰もその仕事を確認していません。
これらを欠いた自信満々の答えは、賢そうに聞こえるコイン投げです。必要なのは小さな意思決定の仕組みで、共有ドキュメント1つとチャット画面2つがあれば動かせます。
今週から使える6ステップ
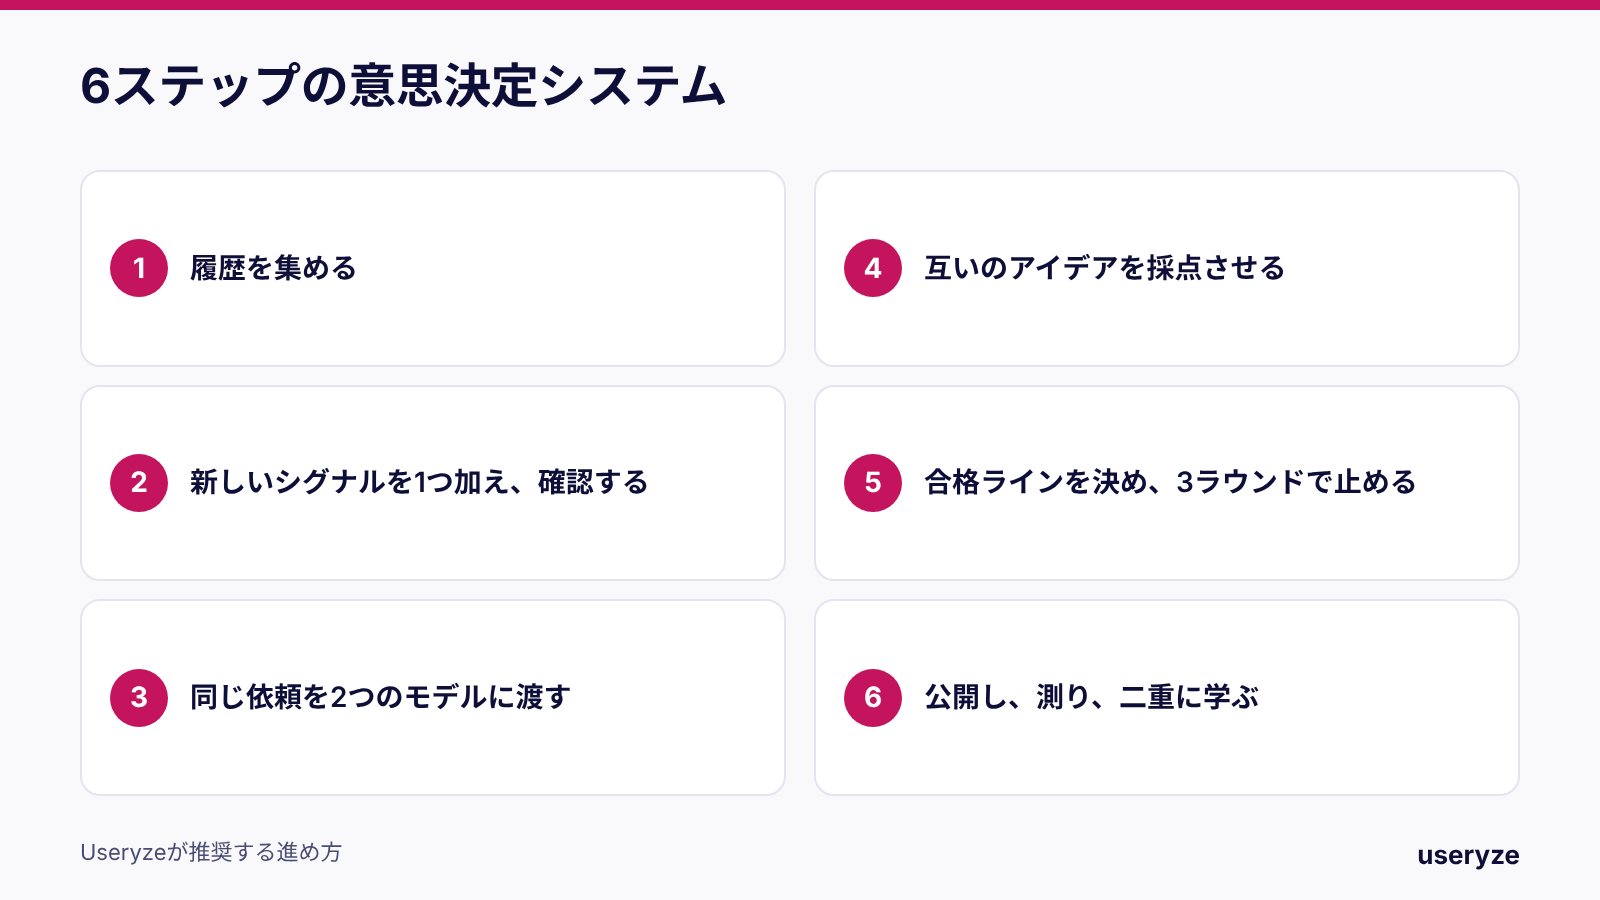
ステップ1:履歴を集める
直近20件のキャンペーン、特別企画、営業メールを、結果と合わせて集めます。飲食店なら、売り切れた特別メニューと、厨房に戻された料理を書き出します。小売店なら、在庫が動いた販促と、利益を削っただけの販促です。私たちの場合、履歴の中の1つの事実が全体を左右しました。複数キャラクターが登場するコントは成績が悪かったため、最も複雑なコンセプトは、誰かが惚れ込む前に最下位に置かれました。
ステップ2:新しい外部シグナルを1つ加え、確認する
履歴は何が効いたかを教えてくれます。シグナルはいま何が重要かを教えてくれます。地域のイベント、競合の値上げや値下げ、祝日、顧客が急に尋ねるようになった質問などです。AIは日付や細部を間違えます。時期に関わる情報は、公開前に必ず元の情報源で確認してください。
ステップ3:同じ依頼を2つのモデルに渡す
同じ依頼、同じ文脈、異なる2つのモデル。対象の顧客、予算、ブランド、やらないと決めていることを伝えます。それぞれに独自のアイデアを出させます。
ステップ4:互いのアイデアを採点させる
採点基準は、アイデアを見る前に書きます。私たちの基準は、最初の2秒、分かりやすさ、シェアされやすさ、自社の商品との相性、そして本当に制作できるかどうか、でした。そのうえで各モデルに、自分のではなく相手の案を採点させます。
相互レビューは実際の問題を見つけました。一方のモデルは、プラットフォームごとに1本ずつ動画を割り当てていました。もう一方は、プラットフォームごとに視聴者が違うので、それではアイデアを比較できないと指摘しました。また、ノートパソコンがまだ届いていないのに「買ったばかりのMacBook」と書かれた台本も見つけました。小さな指摘ですが、そのまま公開していれば信頼を大きく損なったはずです。
ステップ5:合格ラインと上限を決める
9点が何を意味するかを言葉にします。3ラウンドで止めます。止めるルールがなければ、いつまでも磨き続けてしまいます。私たちは12のコンセプトを3つの候補に絞り、残したメモはシンプルでした。点数を追うためだけに6つのバリエーションを作らない、です。
そして選ぶのはあなたです。モデルではありません。
ステップ6:公開し、測り、二重に学ぶ
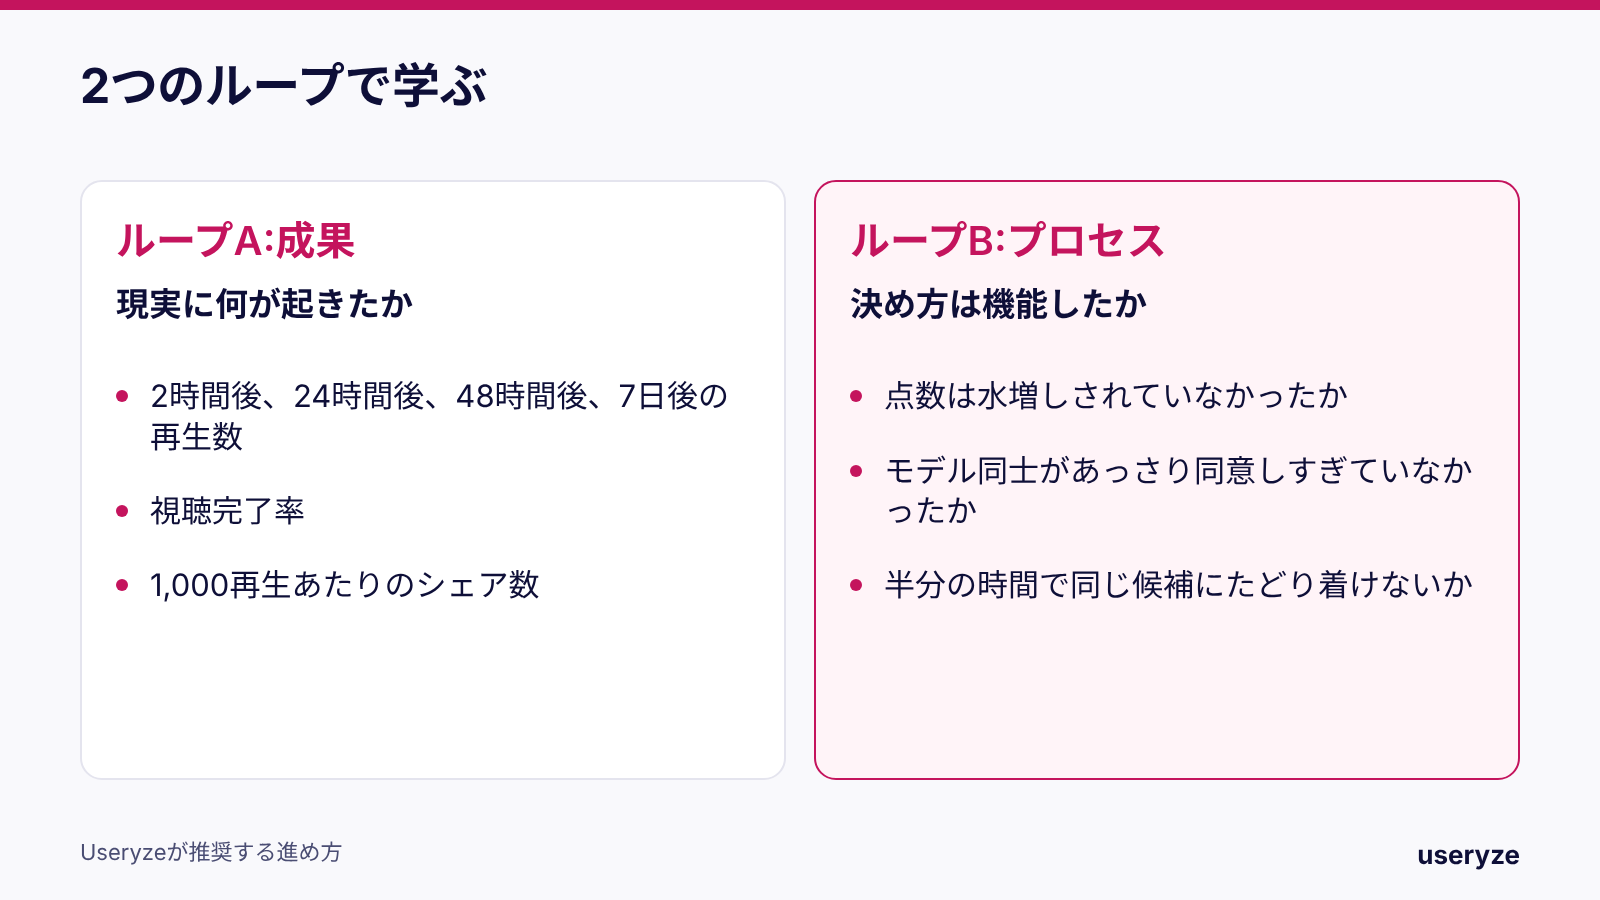
多くのチームは1つのループで学びます。2つ使いましょう。
- ループA(成果): 現実に何が起きたか。私たちは2時間後、24時間後、48時間後、7日後の再生数、視聴完了率、1,000再生あたりのシェア数を記録します。
- ループB(プロセス): 決め方は機能したか。点数は水増しされていなかったか。モデル同士があっさり同意しすぎていなかったか。半分の時間で同じ候補にたどり着けないか。
アイデアと実行は別々に採点する
実行できない素晴らしいアイデアの価値はゼロです。今回のテストでは、すべてのコンセプトに実現可能性の点数も付けました。
私たちの制作ツールはAI動画生成ツールで、癖があります。ロゴを頼むと、勝手に作ってしまうことがあります。焼き込み字幕は誤字になることがあります。物を持つ手は不自然になります。そこでルールはこうなりました。場所は1つ、話者は1人、本物のロゴと字幕は編集で追加する。衣装とロケ地が最も多いコンセプトは実現可能性の点数が最も低く、制作されませんでした。
あなたの場合は、金曜の夜の厨房では盛り付けきれない料理や、決済システムが対応できない販促かもしれません。両方を採点しましょう。
まだ分かっていないこと
この実験から生まれた動画は、いま公開が始まったところです。このプロセスでより良い動画ができるとは、まだ言えません。言えるのは、どの動画を作るかの判断が良くなり、公開前にミスを見つけられたということです。実際の数字は、良くても悪くても私たちのチャンネルで共有します。
あなたのビジネスでの使いどころ
同じ6ステップは、判断を誤ると時間やお金を失うあらゆる場面で使えます。
- キャンペーンやコンテンツのアイデア。 顧客の検索から作るコンテンツ計画と組み合わせるか、コンテンツマーケティングを私たちのチームにお任せください。
- 広告の切り口とオファー。 議論を続ける代わりに、有料広告で実際の予算を使って候補を試します。
- ランディングページ。 見出しはモデルに議論させ、最後はコンバージョン最適化で訪問者に決めてもらいます。
- フォローアップの文面。 新しい見込み客が最初に受け取る返信を書き、CRMとフォローアップで自動化します。
チャット画面の間でテキストをコピーせずにこのループ全体を回したい場合は、私たちのAIエージェントがそれを担います。シグナルを集め、選択肢を作り、相互に検証し、判断をあなたに渡します。
チャプター付きの動画ページもご覧いただけます。
よくある質問
ビジネスにはChatGPTとClaudeのどちらが良いですか?
今回のテストで役に立った答えは「両方」でした。それぞれが相手の見落とした弱点を見つけ、相互レビューによって、自己採点で水増しされていた点数が下がりました。ご自身の判断で両方を試してください。
なぜ2つのモデルは同じアイデアにこれほど違う点数を付けたのですか?
モデルは自分のアイデアに甘くなりがちです。同じ文書化された基準で相手のモデルが採点すると、点数は9.6から6.5に下がりました。主な理由は、中心となるジョークが機能していなかったことです。
何ラウンド行えばよいですか?
3ラウンドです。1回目で基準ができ、2回目で水準を上げ、3回目が最終レビューです。それ以降は改善ではなく磨き込みになります。
特別なソフトウェアは必要ですか?
いいえ。共有ドキュメント1つとチャット画面2つで始められます。自動化は、手作業で明らかに成果が出てからにしましょう。
選ばれたアイデアはうまくいきましたか?
結果はまだ出ていません。このプロセスは判断を良くしました。成果も良くなったかどうかは、ループAが教えてくれます。
言語: English · Español · Português · Bahasa Indonesia · Français · Deutsch · Nederlands