ChatGPT vs. Claude: Das KI-Entscheidungssystem in 6 Schritten, das wir vor jeder Idee anwenden
Wir haben ChatGPT und Claude die Ideen des jeweils anderen bewerten lassen. Aus einer 9,6 wurde eine 6,5. Das ist das System, das daraus entstand, und so nutzen Sie es noch diese Woche.
Useryze · Veröffentlicht
Kurz gesagt: Fragen Sie nicht ein einzelnes KI-Modell nach einer Antwort, um sie dann einfach umzusetzen. Geben Sie zwei Modellen dasselbe Briefing, lassen Sie jedes die Ideen des anderen nach Regeln bewerten, die Sie vorher aufgeschrieben haben, legen Sie eine klare Qualitätsschwelle fest, hören Sie nach drei Runden auf und treffen Sie die Entscheidung selbst. Wir haben das an einem echten Projekt getestet. ChatGPT gab einer eigenen Idee 9,6 von 10 Punkten. Claude prüfte dieselbe Idee und gab ihr 6,5. In dieser Lücke steckt die ganze Lektion.
Die 9,6, aus der eine 6,5 wurde
Wir brauchten Ideen für Kurzvideos zur Woche des GTA-6-Starts. Statt ein Modell um eine Liste zu bitten, setzten wir ChatGPT und Claude in ein gemeinsames Dokument und ließen sie gegeneinander antreten.
Die erste Runde verlief höflich. Jedes Modell schrieb drei Konzepte und bewertete dann alle sechs. Bei jedem Konzept lagen die beiden Noten weniger als einen Punkt auseinander. Die beste Idee bekam 8,5 von Claude und 8,8 von ChatGPT.
Das sieht nach einem Beweis aus. Es ist keiner. Zwei Modelle, die zu großen Teilen mit demselben Internet trainiert wurden, können dieselben blinden Flecken haben. Einigkeit ist nicht dasselbe wie Recht haben.
Also legten wir die Latte höher und baten beide um Ideen, die ehrlich auf 9,5 zielen konnten. ChatGPT kam mit drei neuen Konzepten und Zielnoten von 9,6, 9,6 und 9,7 zurück. Claude schrieb drei eigene und bewertete sie mit 9,2 bis 9,5. Kaum fragten wir nach Neunen, lieferten beide Modelle Neunen.
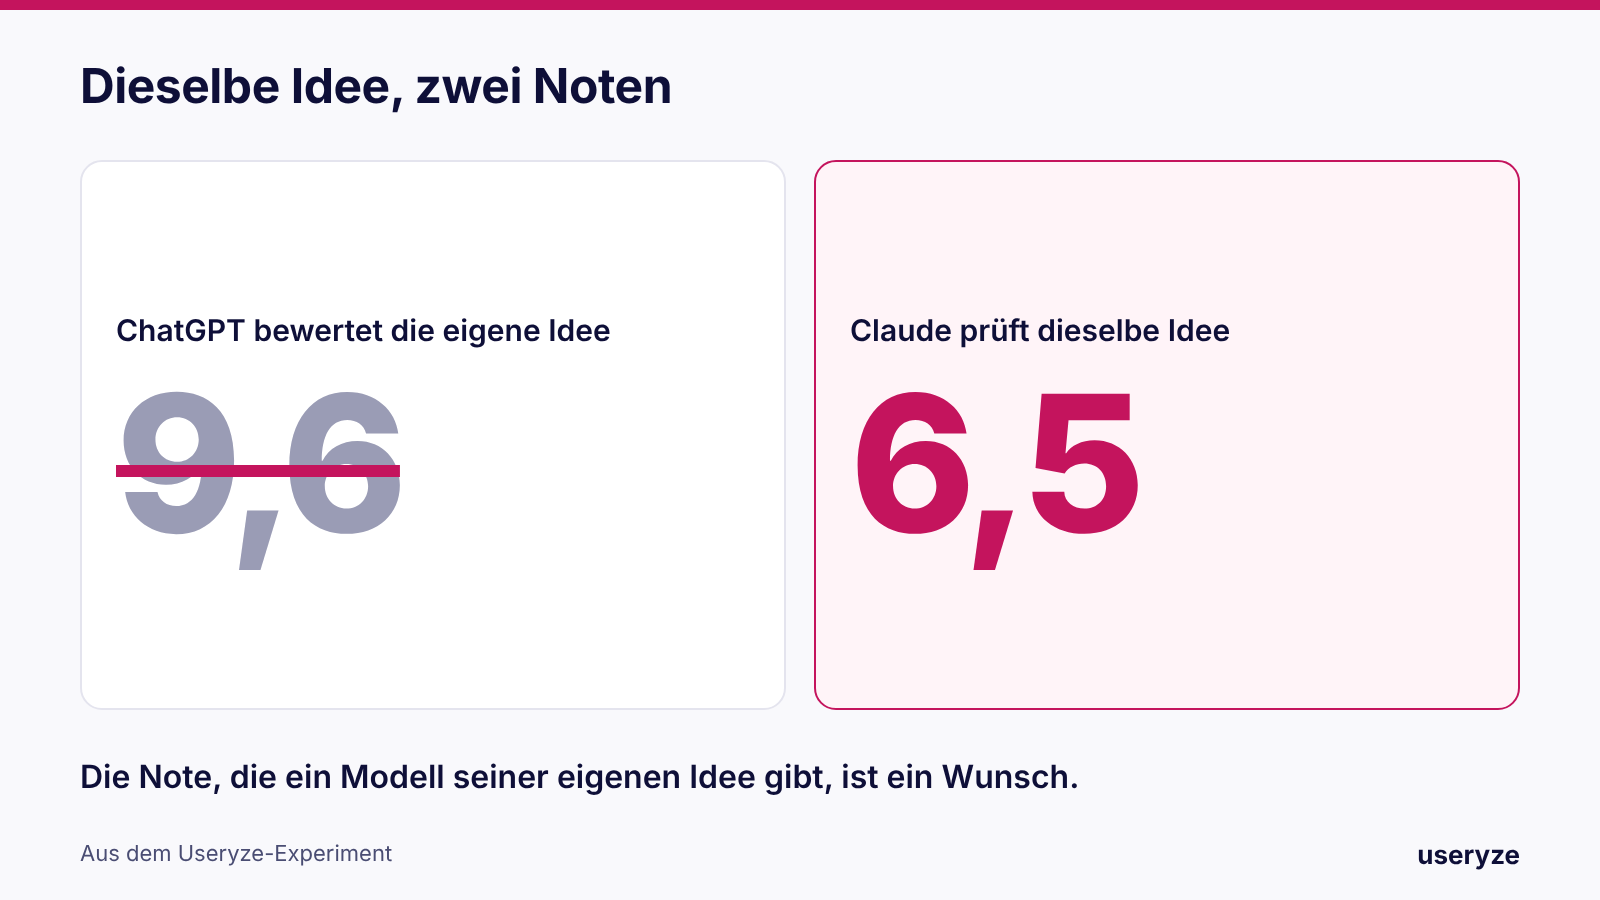
Dann tauschten sie die Arbeiten. Aus der 9,6 wurde eine 6,5, weil der zentrale Witz nicht trug. Claudes eigener Favorit rutschte wegen eines schwachen Einstiegs von 9,5 auf 9,2. ChatGPT schrieb daraufhin, die ursprünglichen Noten seien Wunschwerte und zu hoch angesetzt gewesen.
Die Note, die ein Modell seiner eigenen Idee gibt, ist ein Wunsch.
Warum ein einzelner Prompt ein Münzwurf ist
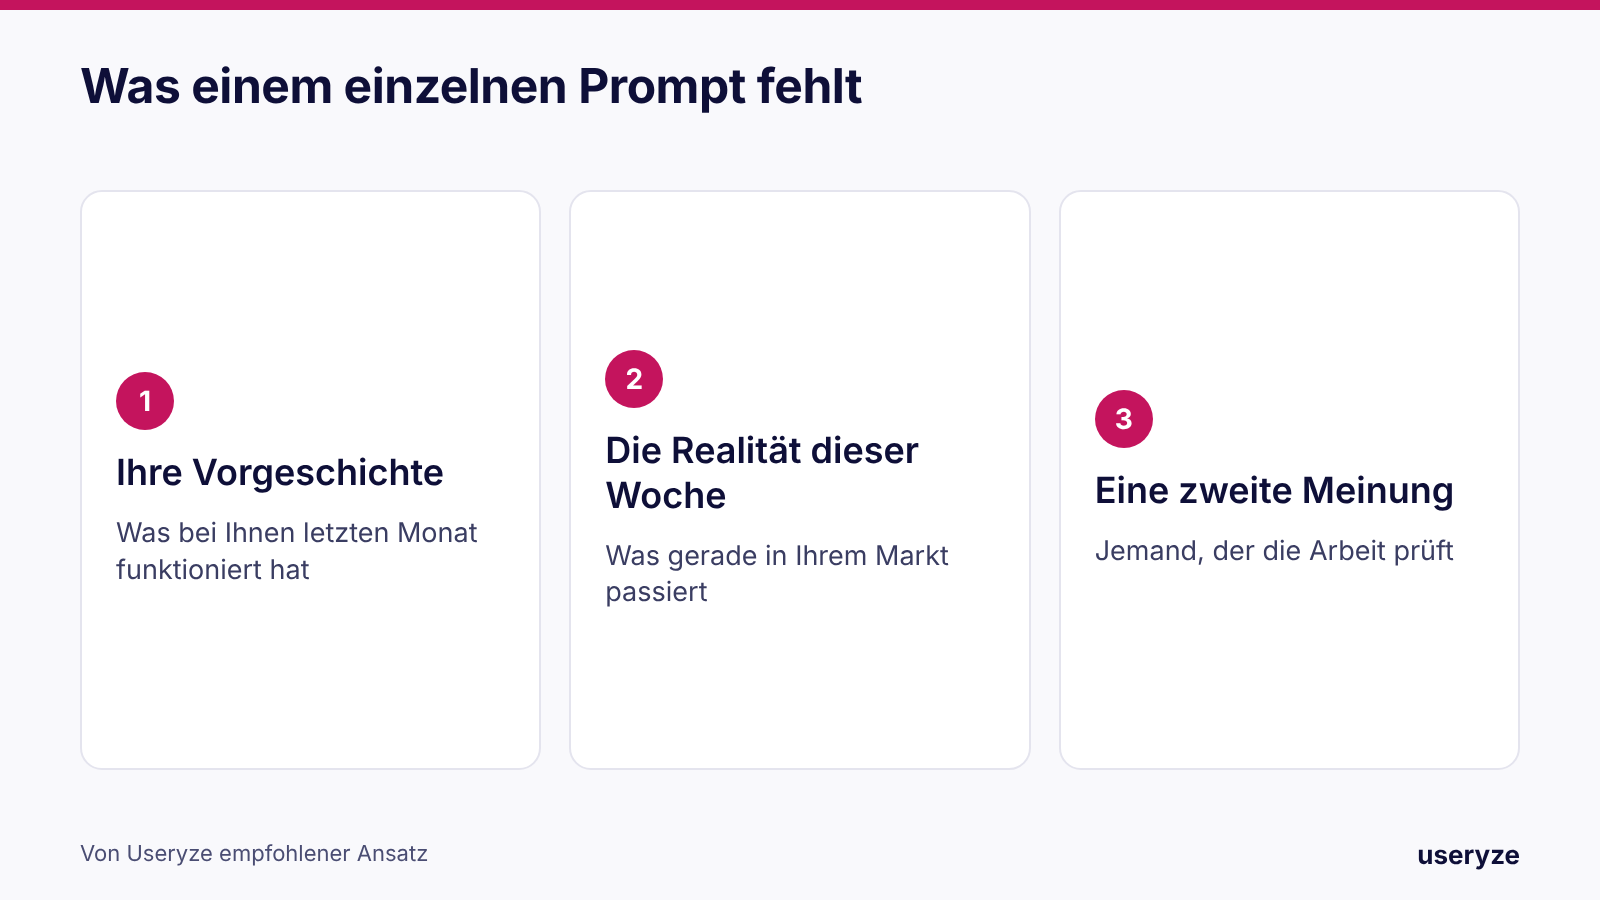
So nutzen die meisten von uns KI: Frage eintippen, selbstsichere Antwort bekommen, umsetzen. Drei Dinge fehlen:
- Ihre Vorgeschichte. Das Modell weiß nicht, was bei Ihnen letzten Monat funktioniert hat.
- Die Realität dieser Woche. Es weiß nicht, was gerade in Ihrem Markt passiert.
- Eine zweite Meinung. Niemand prüft seine Arbeit.
Eine selbstsichere Antwort ohne all das ist ein Münzwurf, der klug klingt. Sie brauchen ein kleines Entscheidungssystem, und dafür reichen ein gemeinsames Dokument und zwei Chatfenster.
Das System in sechs Schritten für diese Woche
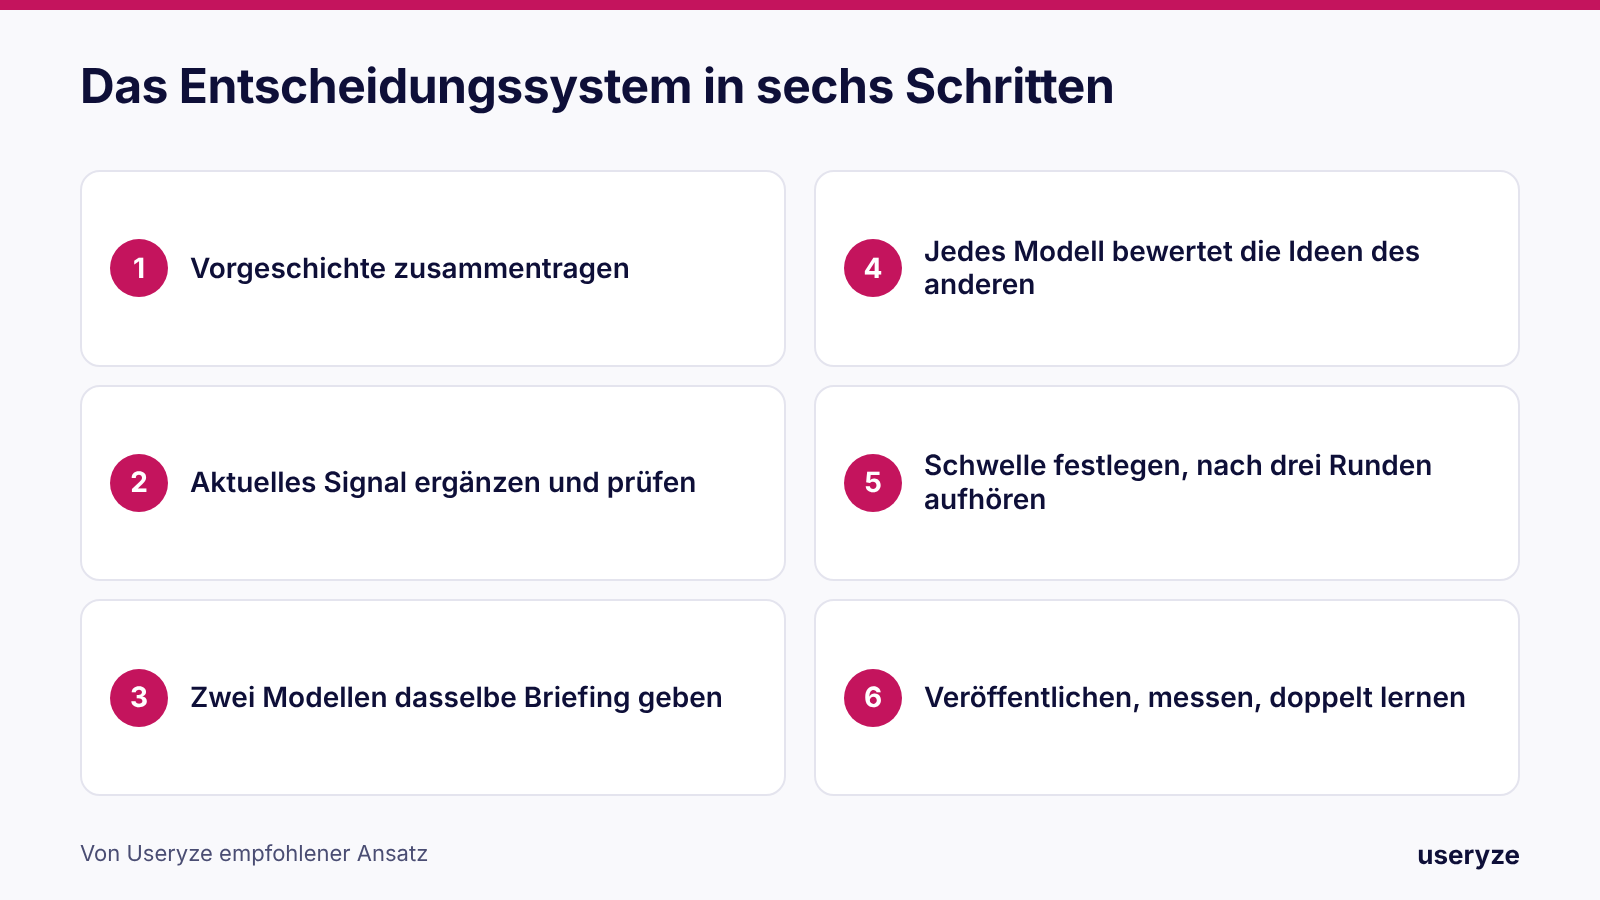
Schritt 1: Tragen Sie Ihre Vorgeschichte zusammen
Sammeln Sie Ihre letzten 20 Kampagnen, Aktionen oder Vertriebs-E-Mails, jeweils mit dem Ergebnis. Ein Restaurant kann notieren, welche Tagesgerichte ausverkauft waren und welche zurückgingen. Ein Händler, welche Aktionen Ware bewegt haben und welche nur Marge gekostet haben. Bei uns prägte eine Tatsache aus der Vorgeschichte alles: Unsere Sketche mit mehreren Figuren hatten schwach abgeschnitten, also landete das komplizierteste Konzept auf dem letzten Platz, bevor sich jemand darin verlieben konnte.
Schritt 2: Ergänzen Sie ein aktuelles Signal von außen und prüfen Sie es
Die Vorgeschichte zeigt, was funktioniert hat. Signale zeigen, was jetzt zählt: ein lokales Ereignis, eine Preisänderung beim Wettbewerb, ein Feiertag, eine Frage, die Kunden plötzlich ständig stellen. KI irrt sich bei Daten und Details. Prüfen Sie deshalb alles Zeitkritische an der Originalquelle, bevor es rausgeht.
Schritt 3: Geben Sie zwei Modellen dasselbe Briefing
Dasselbe Briefing, derselbe Kontext, zwei verschiedene Modelle. Nennen Sie Zielgruppe, Budget, Marke und das, was Sie nicht tun wollen. Bitten Sie jedes Modell um eigene Ideen.
Schritt 4: Lassen Sie jedes Modell die Ideen des anderen bewerten
Schreiben Sie die Bewertungsregeln auf, bevor Sie eine einzige Idee sehen. Unsere lauteten: die ersten zwei Sekunden, wie leicht es zu verstehen ist, wie wahrscheinlich es geteilt wird, wie gut es zu unserem Angebot passt und ob wir es wirklich produzieren können. Dann bewertet jedes Modell die Arbeit des anderen, nicht die eigene.
Die gegenseitige Prüfung deckte echte Probleme auf. Ein Modell hatte jeder Plattform genau ein Video zugeordnet. Das andere wies darauf hin, dass sich Ideen so nicht vergleichen lassen, weil jede Plattform ein anderes Publikum hat. Außerdem fiel ein Skript auf, in dem von „meinem brandneuen MacBook“ die Rede war, obwohl der Laptop noch gar nicht geliefert war. Eine Kleinigkeit, die viel Vertrauen gekostet hätte, wäre sie veröffentlicht worden.
Schritt 5: Legen Sie Schwelle und Grenze fest
Definieren Sie, was eine Neun bedeutet. Hören Sie nach drei Runden auf. Ohne Abbruchregel feilen Sie endlos weiter. Wir kamen von 12 Konzepten auf eine Auswahl von drei, und unsere Notiz dazu war einfach: keine sechs Varianten produzieren, nur um einer Zahl nachzujagen.
Dann entscheiden Sie. Nicht die Modelle.
Schritt 6: Veröffentlichen, messen und doppelt lernen
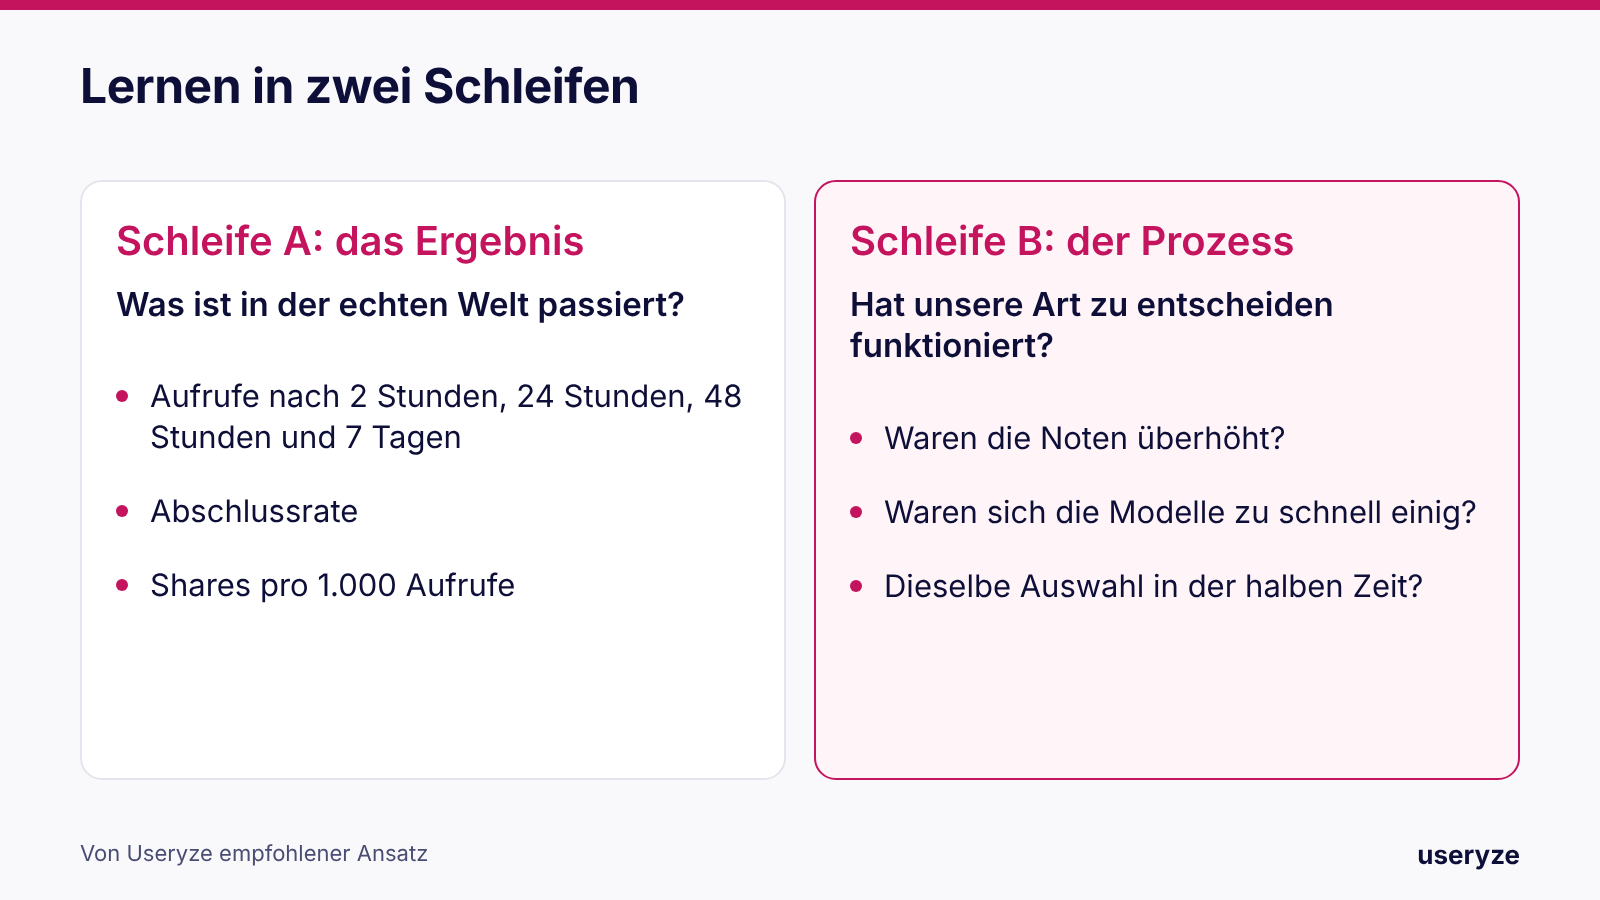
Die meisten Teams lernen in einer Schleife. Nutzen Sie zwei.
- Schleife A, das Ergebnis: Was ist in der echten Welt passiert? Wir erfassen die Aufrufe nach 2 Stunden, 24 Stunden, 48 Stunden und 7 Tagen, die Abschlussrate und die Shares pro 1.000 Aufrufe.
- Schleife B, der Prozess: Hat unsere Art zu entscheiden funktioniert? Waren die Noten überhöht? Waren sich die Modelle zu schnell einig? Kämen wir in der halben Zeit zur selben Auswahl?
Bewerten Sie Idee und Umsetzung getrennt
Eine brillante Idee, die Sie nicht umsetzen können, ist nichts wert. Jedes Konzept in unserem Test bekam eine zweite Note für die Machbarkeit.
Unser Produktionswerkzeug ist ein KI-Videogenerator, und er hat Eigenheiten. Bittet man ihn um ein Logo, erfindet er womöglich eines. Eingebrannte Untertitel können Tippfehler enthalten. Hände, die Gegenstände halten, sehen seltsam aus. Also galten diese Regeln: ein Ort, eine sprechende Person, echtes Logo und Untertitel erst im Schnitt. Das Konzept mit den meisten Outfits und Drehorten bekam die schlechteste Machbarkeitsnote und wurde nie produziert.
Bei Ihnen ist es vielleicht ein Gericht, das die Küche an einem Freitagabend nicht anrichten kann, oder eine Aktion, die Ihr Bezahlvorgang nicht abbildet. Bewerten Sie beides.
Was wir noch nicht wissen
Die Videos aus diesem Experiment werden gerade erst veröffentlicht. Wir können noch nicht sagen, dass dieser Prozess bessere Videos hervorbringt. Wir können sagen, dass er zu besseren Entscheidungen darüber geführt hat, welche Videos wir machen, und dass er Fehler gefunden hat, bevor sie live gingen. Die echten Zahlen teilen wir auf unserem Kanal, ob gut oder schlecht.
Wo das in Ihrem Unternehmen passt
Dieselben sechs Schritte funktionieren bei jeder Entscheidung, bei der ein Fehler Zeit oder Geld kostet:
- Kampagnen- und Content-Ideen. Kombinieren Sie das System mit einem Content-Plan, der auf den Suchanfragen Ihrer Kunden beruht, oder überlassen Sie unserem Team Ihr Content-Marketing.
- Anzeigenansätze und Angebote. Testen Sie die Auswahl mit echtem Budget in bezahlter Werbung, statt darüber zu diskutieren.
- Landingpages. Lassen Sie die Modelle über die Überschrift streiten und die Besucher mit Conversion-Optimierung entscheiden.
- Follow-up-Texte. Schreiben Sie damit die erste Antwort, die ein neuer Lead erhält, und automatisieren Sie sie mit CRM und Follow-up.
Wenn die ganze Schleife laufen soll, ohne dass Sie Text zwischen Chatfenstern kopieren, übernehmen das unsere KI-Agenten: Sie sammeln die Signale, entwerfen die Optionen, prüfen sie gegenseitig und legen Ihnen die Entscheidung vor.
Sie können sich auch die Seite zum vollständigen Video mit Kapiteln ansehen.
Häufige Fragen
Ist ChatGPT oder Claude besser für Unternehmen?
In diesem Test lautete die hilfreiche Antwort: beide. Jedes Modell fand Schwächen, die dem anderen entgangen waren, und die gegenseitige Prüfung drückte Noten, die überhöht waren, solange ein Modell die eigene Arbeit bewertete. Testen Sie beide an Ihren eigenen Entscheidungen.
Warum haben die beiden Modelle dieselbe Idee so unterschiedlich bewertet?
Modelle sind mit eigenen Ideen meist großzügig. Vom anderen Modell nach denselben schriftlichen Regeln bewertet, fiel die Idee von 9,6 auf 6,5, vor allem weil ihr zentraler Witz nicht funktionierte.
Wie viele Runden sollte ich machen?
Drei. Die erste liefert eine Ausgangsbasis, die zweite legt die Latte höher, die dritte ist die Schlussprüfung. Danach polieren Sie nur noch, Sie verbessern nicht mehr.
Brauche ich spezielle Software?
Nein. Ein gemeinsames Dokument und zwei Chatfenster genügen für den Anfang. Automatisieren Sie erst, wenn sich die manuelle Version eindeutig lohnt.
War die Gewinneridee erfolgreich?
Ergebnisse liegen noch nicht vor. Der Prozess hat die Entscheidung verbessert. Ob er auch das Ergebnis verbessert hat, zeigt Schleife A.
Sprachen: English · Español · 日本語 · Português · Bahasa Indonesia · Français · Nederlands